
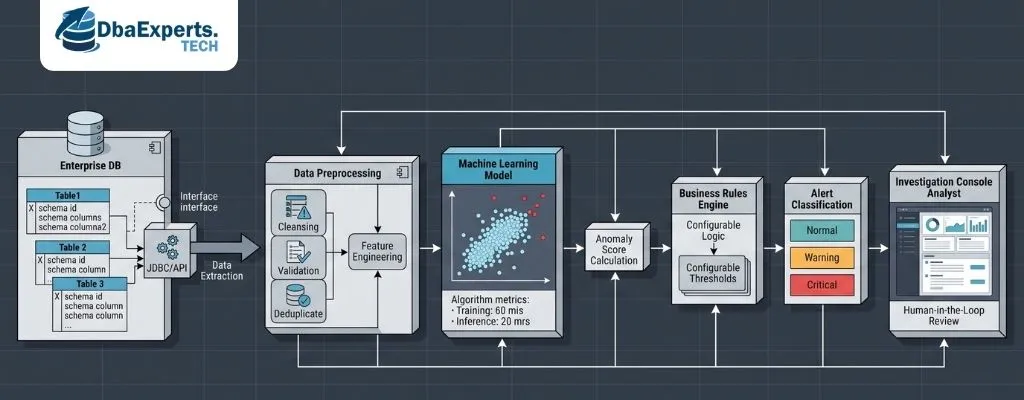
El Machine Learning (ML) puede convertirse en una herramienta poderosa para detección de anomalías en BDs identificando comportamientos que se alejan de los patrones esperados. Una base de datos empresarial puede procesar millones de registros diariamente. Ventas, transacciones, accesos, inventarios, movimientos financieros, registros de clientes y eventos operativos generan continuamente información que cambia de comportamiento con el tiempo.
El problema es que no todas las anomalías son evidentes. Un aumento inesperado de transacciones puede ser fraude, pero también una campaña exitosa. Una caída en los pedidos puede representar un problema técnico, una estacionalidad o un cambio real en el comportamiento de los clientes.
Google define la detección de anomalías como el proceso de identificar valores atípicos (outliers) respecto a un comportamiento esperado. Como líderes de un equipo especializado en data, consideramos que el verdadero valor no está simplemente en encontrar registros “raros”, sino en detectar cambios relevantes antes de que se conviertan en problemas de negocio.
¿Qué es una anomalía en una base de datos?
Una anomalía es una observación o comportamiento que se desvía significativamente del patrón esperado. Por ejemplo:
- Una transacción por un valor excepcionalmente alto.
- Un aumento repentino de registros duplicados.
- Una caída anormal en el volumen de ventas.
- Un usuario realizando consultas inusuales.
- Una tabla que recibe menos registros de lo habitual.
- Un incremento inesperado en tiempos de consulta.
- Un cambio brusco en la distribución de una variable.
- Un proceso ETL que comienza a generar valores fuera de rango.
Lo importante es que una anomalía no necesariamente significa un error, pero es una señal que requiere investigación.
¿Por qué utilizar Machine Learning?
Las reglas tradicionales funcionan muy bien cuando conocemos exactamente qué debemos buscar. Por ejemplo:
“Generar una alerta si una transacción supera los $10 millones.”
El problema aparece cuando los patrones son más complejos, un comportamiento puede ser normal para un cliente y extraño para otro. Una cifra puede ser habitual durante diciembre pero anormal en marzo. Una combinación de variables puede revelar un problema que ninguna regla individual detectaría.
El Machine Learning permite aprender patrones a partir de los datos y utilizar esos patrones para identificar desviaciones. Microsoft, por ejemplo, documenta técnicas de detección de anomalías basadas en PCA para escenarios donde resulta difícil obtener suficientes ejemplos etiquetados de anomalías.
Paso 1: Definir qué queremos detectar
Antes de elegir un algoritmo, debemos definir el problema, esta es una de las etapas que más suele subestimarse. No es lo mismo detectar:
- Anomalías de calidad: registros incompletos, duplicados o valores inesperados.
- Anomalías operativas: cambios en volumen, tiempos de procesamiento o disponibilidad.
- Anomalías transaccionales: comportamientos financieros o comerciales fuera de patrón.
- Anomalías de seguridad: accesos, consultas o comportamientos potencialmente sospechosos.
- Anomalías temporales: desviaciones respecto a patrones históricos.
Lo que nos interesa en mayor medida es ¿Qué comportamiento normal queremos aprender y qué desviación tendría valor para el negocio?
Paso 2: Preparar los datos
Un modelo de Machine Learning será tan útil como los datos que recibe, antes de entrenar un detector debemos revisar:
- Valores faltantes.
- Duplicados.
- Datos corruptos.
- Cambios de esquema.
- Valores extremos.
- Frecuencia de actualización.
- Variables irrelevantes.
- Escalas diferentes.
- Cambios históricos en el comportamiento.
Google recomienda visualizar y analizar estadísticamente los datos numéricos antes de avanzar con la construcción de características, precisamente porque estas etapas pueden revelar anomalías y patrones ocultos. Esto significa que la detección de anomalías comienza con data profiling, no con el algoritmo.
Paso 3: Construir las variables correctas
Supongamos que queremos detectar anomalías en transacciones, no necesariamente debemos alimentar el modelo únicamente con el valor de cada transacción. Podemos construir variables como:
- Valor de la transacción.
- Número de transacciones por hora.
- Promedio histórico del cliente.
- Desviación respecto al comportamiento habitual.
- Ubicación.
- Tipo de operación.
- Hora del día.
- Frecuencia de operaciones.
- Distancia entre transacciones.
- Relación entre diferentes variables.
Estas características permiten que el modelo detecte comportamientos, no solamente valores extremos.
Paso 4: Elegir el enfoque de Machine Learning
No existe un único algoritmo adecuado para todos los escenarios acá te listamos los principales:
Modelos estadísticos
Son útiles cuando conocemos razonablemente bien la distribución de los datos y buscamos desviaciones respecto a valores esperados.
PCA
El análisis de componentes principales puede utilizarse para identificar observaciones que se alejan de la estructura predominante de múltiples variables. Microsoft utiliza precisamente PCA en uno de sus enfoques de detección de anomalías.
Isolation Forest
Este enfoque busca aislar observaciones que presentan características diferentes respecto al resto del conjunto. Puede ser útil cuando tenemos múltiples variables y pocos ejemplos etiquetados.
Clustering
Los algoritmos de agrupamiento permiten identificar grupos de comportamiento y posteriormente detectar observaciones alejadas de esos grupos.
Modelos temporales
Cuando el comportamiento depende del tiempo, podemos analizar tendencias, estacionalidad y cambios repentinos. En escenarios modernos también pueden utilizarse arquitecturas multivariadas capaces de analizar simultáneamente diferentes series y variables. Microsoft documenta, por ejemplo, flujos de detección multivariante en Fabric para entrenar modelos y puntuar nuevas observaciones.
Paso 5: Establecer un sistema de puntuación
Un detector de anomalías normalmente produce un score que representa qué tan diferente es una observación respecto al comportamiento aprendido. Pero aquí aparece una decisión empresarial importante:
¿A partir de qué nivel generamos una alerta?
Un umbral demasiado bajo producirá cientos de alertas y puede saturar al equipo. Uno demasiado alto puede hacer que anomalías importantes pasen desapercibidas. Por eso recomendamos establecer niveles:
- Normal: no requiere intervención.
- Observación: revisar tendencia.
- Alerta: requiere análisis.
- Crítico: requiere acción inmediata.
El objetivo no es maximizar la cantidad de alertas. El objetivo es maximizar el valor de las alertas.
Machine Learning + reglas de negocio
Una arquitectura madura no tiene por qué elegir entre reglas tradicionales y Machine Learning, ya que puede combinar ambos enfoques. Por ejemplo:
Regla: una transacción superior a determinado límite requiere revisión.
ML: el comportamiento general de esa transacción también se compara con el patrón histórico del cliente.
Esto permite construir sistemas híbridos donde las reglas capturan condiciones conocidas y ML identifica patrones que no fueron definidos explícitamente.
Del modelo a la base de datos
Una arquitectura típica puede seguir este flujo:
Base de datos → extracción → preparación → features → modelo ML → anomaly score → reglas de negocio → alerta → investigación → acción
En algunos casos, el análisis puede realizarse prácticamente en tiempo real. Microsoft documenta arquitecturas en las que los detectores analizan tablas de eventos y permiten establecer monitoreo continuo y alertas para anomalías futuras. Esto resulta especialmente interesante para plataformas con grandes volúmenes de eventos.
¿Cómo evitar demasiados falsos positivos?
Este es uno de los principales retos puesto que un sistema que detecta 1.000 anomalías diariamente pero solamente produce cinco incidentes relevantes puede terminar siendo ignorado y para reducir este problema recomendamos:
- Contextualizar: analizar el comportamiento según cliente, producto, región o periodo.
- Segmentar: no comparar poblaciones que tienen comportamientos naturalmente diferentes.
- Incorporar estacionalidad: considerar patrones horarios, semanales, mensuales y anuales.
- Retroalimentar el modelo: registrar cuáles alertas fueron realmente relevantes.
- Medir precisión operacional: no solamente el desempeño matemático del modelo.
NIST señala que los sistemas de detección basados en Machine Learning pueden ser prometedores para identificar comportamientos anómalos, pero también existen desafíos relacionados con precisión, recall y consistencia frente a diferentes tipos de amenazas.
¿Qué KPIs deberíamos medir?
Un proyecto de detección de anomalías debería medir algo más que “cuántas anomalías encontramos”. Recomendamos monitorear:
- Número de anomalías detectadas.
- Tasa de falsos positivos.
- Tasa de falsos negativos.
- Precisión de las alertas.
- Tiempo medio de detección.
- Tiempo medio de resolución.
- Porcentaje de alertas investigadas.
- Incidentes confirmados.
- Costo evitado.
- Procesos protegidos.
De esta manera podemos conectar el modelo con resultados reales de negocio.
La anomalía es una señal, no una sentencia
Este principio es fundamental porque el Machine Learning no debería convertirse en una máquina automática de acusaciones porque una anomalía indica que algo se comporta de manera diferente. La interpretación depende del contexto.
Una venta extraordinariamente alta puede ser fraude, pero también puede ser el mejor negocio del mes. Un aumento de consultas a una tabla puede indicar un ataque, pero también una nueva campaña de marketing. Por eso, la arquitectura debe permitir investigación y supervisión humana.
Observabilidad inteligente de datos
La detección de anomalías está evolucionando desde sistemas reactivos hacia arquitecturas de observabilidad inteligente de datos. En lugar de esperar a que alguien descubra que un dashboard está equivocado, el sistema puede detectar automáticamente que el volumen de registros cayó, que una distribución cambió o que una fuente comenzó a entregar datos diferentes.
Esto conecta Machine Learning con Data Quality, Data Observability y Data Governance. NIST ha investigado precisamente mecanismos de detección de comportamiento anómalo para identificar condiciones inusuales y amenazas en diferentes entornos.
Detectar anomalías en bases de datos usando Machine Learning no consiste simplemente en entrenar un modelo y esperar alertas. El verdadero desafío está en construir una cadena confiable:
datos de calidad → características relevantes → modelo adecuado → umbrales contextualizados → alertas útiles → investigación → acción.
Cuando esta arquitectura está bien diseñada, Machine Learning puede convertirse en una capa inteligente de protección y observabilidad para los activos de datos.
En DBA Experts creemos que el valor de la inteligencia artificial aplicada a datos no está en detectar más anomalías, sino en detectar antes aquello que realmente puede afectar al negocio.
Sigue el blog de DBA Experts para encontrar nuevos análisis y contenidos especializados. También acompáñanos en LinkedIn, Facebook y X, donde compartimos conocimiento, tendencias y buenas prácticas para convertir los datos en una ventaja estratégica.
Referencias bibliográficas
- National Institute of Standards and Technology (NIST). A Review of Machine Learning-based Zero-day Attack Detection: Challenges and Future Directions. Revisión oficial sobre técnicas de Machine Learning para detectar comportamientos asociados a ataques desconocidos y sus desafíos de evaluación.
NIST — Machine Learning-based Zero-day Attack Detection - Google for Developers. Machine Learning Glossary — Anomaly Detection. Definición oficial de detección de anomalías y conceptos relacionados con outliers y métricas de evaluación.
Google for Developers — Machine Learning Glossary - Microsoft Learn. Machine Learning tasks — Anomaly detection. Documentación oficial sobre detección de anomalías mediante Machine Learning y uso de PCA en escenarios con datos limitados de anomalías etiquetadas.
Microsoft Learn — Anomaly detection - NIST. Data Integrity: Detecting and Responding to Ransomware and Other Destructive Events. Referencia sobre detección y respuesta ante eventos que afectan la integridad de datos, incluyendo registros y bases de datos.
NIST — Data Integrity - NIST. Behavioral Anomaly Detection. Referencia oficial sobre detección de comportamientos anómalos como mecanismo para identificar posibles eventos de seguridad.


